Múltiplos Agentes precisam de medição e coordenação
Para lidar com a complexidade adicional introduzida por sistemas multiagentes, não basta apenas distribuir tarefas. Também é necessário criar mecanismos capazes de monitorar, validar e governar a execução dos agentes. Dentro desse contexto, alguns conceitos ganham importância:
-
Observabilidade
- Tracing→ Qual caminho?
- Logging → O que aconteceu ao longo desse caminho?
- Monitoring → O que esses eventos específicos mostram sobre o comportamento do sistema ao longo do tempo?
-
Qualidade
1. Evals (Evaluations) Esta execução específica apresentou a qualidade esperada?
-
- Regra/código
- Avaliação humana
- LLM-as-Judge
2. Métricas de Qualidade Como está a qualidade do sistema em escala (agregação dos Evals) ao longo do tempo?
-
Segurança
- Guardrails O sistema está obedecendo as regras?
- Permissões Políticas de acesso → O agente pode fazer isso?
- Human in the loop → Quando o humano precisa assumir, validar ou autorizar a decisão?
Esses componentes funcionam como gates de qualidade distribuídos ao longo da execução. Em vez de simplesmente executar uma tarefa e retornar uma resposta, o sistema passa a monitorar, validar, medir e corrigir seu próprio comportamento.
Observabilidade
É a capacidade de entender o comportamento do sistema durante sua execução. Ela permite responder perguntas como:
- O que o agente fez?
- Qual ferramenta foi utilizada?
- Qual informação foi recuperada?
- Onde ocorreu uma falha?
- Qual decisão foi tomada?
Sem observabilidade, um sistema de IA se comporta como uma caixa-preta. Com observabilidade, é possível investigar problemas, auditar decisões e evoluir a solução com confiança.
1. Tracing
É o registro detalhado da jornada de execução de uma solicitação. Em um sistema multiagente, um único pedido pode gerar dezenas de etapas:
2. Logging
É o registro dos eventos específicos ocorridos durante a execução do sistema que acontecem ao longo de todo caminho mostrado no tracing. Eles podem registrar, por exemplo:
- chamadas realizadas a ferramentas e APIs;
- erros e exceções;
- decisões ou etapas executadas pelos agentes;
- tentativas e novas execuções;
- bloqueios realizados por mecanismos de segurança;
- mudanças de estado relevantes.
Exemplo:
3. Monitoring
- Tempo de resposta
- Taxa de erro
- Consumo de tokens
- Uso de ferramentas
- Custos de execução
- Número de avaliações reprovadas
O objetivo é identificar degradações e incidentes antes que afetem os usuários. Perguntas típicas:
-
- O agente está disponível?
- Houve erro?
- A latência aumentou?
- O custo disparou?
- Alguma ferramenta parou de responder?
- Quantos tokens estão sendo consumidos?
Qualidade
1. Evals (Evaluations)
Assim como sistemas tradicionais utilizam testes unitários, integração e regressão para garantir qualidade de software, sistemas baseados em LLM utilizam Evals que são avaliações estruturadas utilizadas para medir a qualidade de comportamentos e respostas produzidas pelos agentes.
Em IA, muitas vezes não existe apenas “certo” ou “errado”. É necessário avaliar aspectos como:
- Precisão
- Relevância
- Completude
- Segurança
- Consistência
- Aderência ao contexto
- Uso correto de ferramentas
Sempre que um prompt, modelo, ferramenta ou fluxo é alterado, os Evals permitem verificar se o sistema melhorou ou degradou sua performance.
Sem Evals, trabalhamos por percepção:
“Acho que ficou melhor.”
Com Evals, trabalhamos por evidência:
“A taxa de aderência aos critérios aumentou de 82% para 91%.”
Perguntas típicas:
A resposta está correta?
A resposta é relevante?
Seguiu o template?
Utilizou a ferramenta correta?
Resultado:
Eval = processo de avaliação. E quem executa essa avaliação pode variar:
- Humano, quando uma pessoa revisa e dá nota/classifica.
- LLM-as-Judge, quando outro modelo avalia a resposta.
- Código/regra determinística, quando é possível verificar automaticamente.
- Híbrido, combinando essas formas.
LLM-as-Judge
Uma das abordagens mais utilizadas para implementar Evals é o LLM-as-Judge.
Nesse padrão, um segundo modelo atua como avaliador da saída produzida por outro agente ou modelo. Fluxo:
Pergunta→Agente Executor→Resposta→LLM Juiz→ Avaliação=Aprovar|Reprovar|Solicitar|Correção
Dessa forma, parte do controle de qualidade deixa de depender exclusivamente da revisão humana e passa a ser automatizada.
Até este ponto, discutimos observabilidade, Evals, LLM-as-Judge e mecanismos de validação. Porém, surge uma pergunta importante:
2. Métricas de Qualidade
São indicadores utilizados para acompanhar o desempenho de um sistema de IA ao longo do tempo. As métricas permitem visualizar tendências e medir a evolução da solução. Alguns exemplos incluem:
-
Taxa de aprovação nos Evals;
- Precisão das respostas;
- Taxa de alucinação;
- Uso correto de ferramentas;
- Aderência a políticas de segurança;
- Satisfação dos usuários;
- Tempo de resposta;
- Taxa de intervenção humana (Human-in-the-Loop).
Essas métricas ajudam equipes de produto, arquitetura e governança a acompanhar a confiabilidade do sistema, identificar degradações e priorizar melhorias na linha do tempo, por exemplo por mês. Perguntas típicas:
Quantas respostas foram aprovadas?
Qual a precisão média?
Quanto tempo o agente leva para responder?
Qual a taxa de uso correto das ferramentas?
Resultado:
Segurança
1. Guardrails
São mecanismos de proteção que definem limites para o comportamento dos agentes. Eles ajudam a evitar:
- Vazamento de informações
- Uso indevido de ferramentas
- Execução de ações não autorizadas
- Prompt Injection
- Respostas fora das políticas corporativas
Em sistemas corporativos, os guardrails funcionam como uma camada de segurança entre o modelo e o mundo real.
2. Permissões
Definem quem ou o que pode acessar dados, ferramentas e executar determinadas ações dentro do sistema. Em sistemas agênticos, elas são especialmente importantes porque um agente pode não apenas consultar informações, mas também agir sobre sistemas corporativos. Por exemplo, um agente pode ter permissão para:
- ✅ Consultar dados no Jira;
- ✅ Ler documentos;
- ✅ Criar uma história;
- ❌ Excluir uma iniciativa;
- ❌ Alterar informações sensíveis.
As permissões aplicam o princípio do menor privilégio: o agente recebe apenas os acessos necessários para executar sua função.
3. Human in the loop
é o mecanismo que insere intervenção humana em pontos específicos da execução do agente, especialmente quando existe risco, incerteza, baixa confiança ou necessidade de autorização. O humano pode ser acionado para:
- Aprovar uma ação antes da execução;
- Revisar uma resposta de baixa confiança;
- Corrigir resultados inadequados;
- Tomar a decisão em situações críticas ou excepcionais.
Ele funciona como uma camada de supervisão, permitindo autonomia ao agente sem necessariamente entregar a ele controle irrestrito.
Quem coordena tudo isso?
AI Harness
É a camada arquitetural responsável por transformar modelos, agentes, ferramentas e mecanismos de avaliação em um sistema operacional de IA coeso e governado.
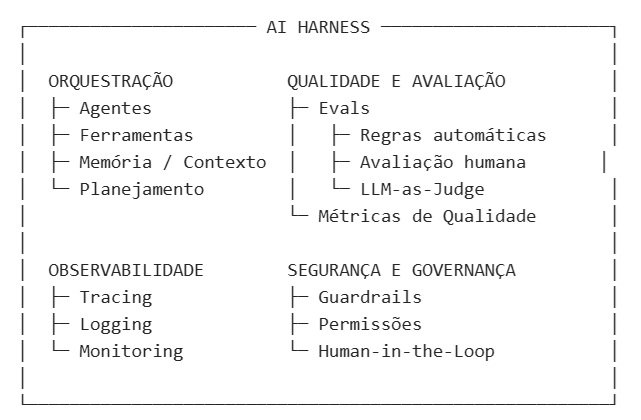
Em arquiteturas simples, pode existir apenas um modelo respondendo diretamente a uma pergunta. Porém, à medida que adicionamos múltiplos agentes, ferramentas corporativas, memória, validações e processos de aprovação, surge a necessidade de uma camada capaz de coordenar todos esses componentes. É exatamente esse o papel do Harness. Ele é responsável por:
- Gerenciar estado e memória;
- Realizar Context Engineering;
- Coordenar agentes e fluxos de trabalho;
- Controlar permissões e acesso a ferramentas;
- Aplicar políticas de segurança e governança;
- Executar Evals;
- Acionar LLMs Juízes quando necessário;
- Registrar logs, métricas e rastreabilidade;
- Implementar mecanismos de recuperação e resiliência;
- Coordenar intervenção humana (Human-in-the-Loop).
O ponto importante é que a qualidade de um sistema agêntico não depende apenas do modelo utilizado. Um Harness transforma esse modelo em um sistema capaz de planejar, executar ações, utilizar ferramentas, tomar decisões sob restrições e operar dentro das regras de negócio da organização.
Sem essa camada de coordenação, esses componentes funcionam de forma isolada. Com ela, passam a atuar como um sistema integrado de execução, controle e aprendizado.
Reumindo, o Harness é, portanto, a arquitetura que conecta:
Planejamento, Simulação e Decisão
Além de coordenar agentes e ferramentas, Harnesses mais avançados podem incorporar mecanismos de planejamento e tomada de decisão, como Self-Consistency, Reflection, Tree of Thoughts, Monte Carlo Sampling e Arbitragem Cognitiva.
Essas técnicas permitem explorar alternativas, avaliar riscos, validar resultados e selecionar estratégias antes da execução. Nesse cenário, o modelo deixa de ser o único responsável pela decisão: o Harness passa a atuar como uma camada de raciocínio operacional que propõe, avalia, corrige e governa a execução.
Em vez de simplesmente receber uma solicitação e executar a primeira solução proposta pelo modelo, o Harness pode explorar múltiplos caminhos possíveis, comparar alternativas e selecionar a opção mais adequada ao contexto.
- O modelo propõe alternativas;
- O Harness avalia cenários;
- O Harness escolhe;
- O Harness executa.
Dessa forma, o agente deixa de ser apenas um modelo respondendo perguntas. O sistema completo passa a funcionar como uma rede coordenada de capacidades cognitivas, onde diferentes modelos e agentes podem ser utilizados conforme a necessidade.
Os modelos tornam-se recursos intercambiáveis; o verdadeiro diferencial passa a ser a arquitetura que governa sua utilização.
“Autonomia não é uma mágica do modelo, mas uma concessão da arquitetura.”
Harness ≠ Plataforma
O Harness não é um produto específico. Ele é uma arquitetura que pode ser construída utilizando diferentes plataformas e frameworks, como:
- Azure AI Foundry
- Copilot Studio
- Semantic Kernel
- LangGraph
- CrewAI
- AutoGen
Essas plataformas fornecem recursos que ajudam a implementar partes do Harness, mas o Harness em si é o desenho arquitetural que integra todos esses componentes em um sistema funcional.
Uma analogia simples:
- LLM = Motor
- Agente = Veículo
- Harness = Carro completo (direção, freios, sensores, painel e sistema de controle)
- Azure AI Foundry = Fábrica que fornece as peças para construir esse carro
Por exemplo, o Foundry disponibiliza recursos como:
- Evaluation
- Tracing
- Monitoring
- Quality Metrics
- Tool Calling
- Grounding
- Knowledge
- Agent Framework
Essas capacidades permitem evoluir de um fluxo simples:
A principal discussão em arquiteturas agênticas modernas não é mais “qual modelo usar?” nem “quantos agentes criar?”. A questão central passa a ser como construir um Harness capaz de coordenar agentes, ferramentas, memória, avaliações e governança de forma observável, segura e confiável. Nesse cenário, os modelos tornam-se recursos cognitivos intercambiáveis; o verdadeiro diferencial competitivo passa a ser a arquitetura que os orquestra.

Informações sobre a autora: Jacqueline é Agile por experiência e entusiasta de IA. Sempre evoluindo! https://www.linkedin.com/in/jacqueline-mba-e-pmp


